


悪意のある可能性がある PowerShell スクリプトによって、ファイルがダウンロードされ実行されるケースについて、サイバーセキュリティアラートが発行される例を考えてみましょう。セキュリティオペレーションセンター (SOC) の AI エージェントは、あらかじめ定められた一連のアクションから選択することで、このアラートに対応します。具体的には、問題のないアラートとしてクローズする、証拠をさらに収集する、またはアナリストにエスカレーションする、といった対応を選択することになります。こうしたアラートへの対応を AI エージェントに任せる前に、SOC はエージェントがどの程度正しく判断できるのか、また、エージェントが自信を持って下した判断が、本当に正しいのか把握する必要があります。
TypeSafe.ai は、このような意思決定を行うために Jev を開発しました。開発者が構造化されたコンテキスト、質問、および回答として許可する選択肢を指定すると、Jev は長文のテキストを生成することなく、各回答候補を選ぶ確率を出力します。TypeSafe は、この設計により、汎用の大規模言語モデル (LLM) と比べて、1 回の意思決定にかかる時間とコストを大幅に削減できるとしています。Latent Space のインタビューで、TypeSafe の共同創業者兼 CEO である Diogo Almeida 氏は、「コードがコンシューマーとなることを目指す」モデル群について説明しています。同氏は、こうした判断の信頼性を十分に高め、開発者がデータベースへのクエリと同じように、日常的に呼び出して利用できるようにしたいと考えています。TypeSafe は、効率性が向上すると需要が十分に増加し、資源の総消費量がかえって増えるという「ジェヴォンズのパラドックス」にちなんで、Jev と名付けました。ここに、Jev が引き起こすパラドックスがあります。Jev による自動意思決定のコストが下がり、あらゆる場面で利用できるようになると、チームははるかに多くの意思決定を自動化するようになります。その結果、1 回あたりの判断にかかるコストが下がっても、意思決定の総数が増えることで、誤った判断の総数も増えてしまう可能性があります。
Jev は常に有効な回答を返すため、システムに組み込みやすいという利点があります。しかし、実際に役立つかどうかは、どの程度の頻度で正しい回答を選べるかによって決まります。さらに、提示した回答の信頼性が低い場合に、それを自ら認識できるのであれば、どこまでの作業を安全に自動化できるかを判断するうえで役立ちます。これらはそれぞれ別の特性ですが、Jev の発表をめぐる注目によって、その違いがやや曖昧になっています。
実行時にラベルを指定できる分類器は、決して新しいものではありません。少なくとも 2019 年以降、自然言語推論モデルは、モデルを再学習させることなく、入力内容が「このアラートは悪意のあるものだ」といった記述を裏付けているかどうかを判定することで、ゼロショット分類を実現してきました。2026 年 3 月に発表されたベンチマークでは、こうしたモデルが、埋め込みモデル、再ランキングモデル、指示チューニング済みの LLM と比較されました。TypeSafe は Jev のアーキテクチャを公開していないため、これらのモデルの中で Jev がどのような位置付けにあるのかは不明です。ただし、後述する既存の研究で取り上げられている手法と、TypeSafe が掲げる「確率が適切に較正された意思決定」という学習目標には、共通する点が見られます。いずれにしても、SOC にとって重要なのは、Jev が技術的に新しいかどうかよりも、実際の業務フローを改善できるかどうかです。その点を検証するうえで、発表後に公開された初期の独立評価は、詳しく検討する価値があります。
Jev の優位性は、何に置き換えるかによって決まる
ある独立機関による評価では、2 つの意図分類ベンチマークを用いて、Jev と OpenAI のモデルが比較されました。評価では、チャットボットに何をさせたいのかをユーザーの発言から特定するためのベンチマーク「CLINC150」から、200 件のリクエストがテストされました。Jev は、学習用の事例を与えない条件で 87% の正解率を達成しました。これに対し、小型モデルの gpt-5.4-nano は 80%、GPT-5.6 Terra は 92% でした。Terra は、OpenAI のモデルラインアップでは GPT-5.6 Sol や GPT-6 Astra より下位に位置します。したがって、Jev はゼロショット分類器としては十分な性能を備えていますが、最先端モデルと同等の品質には達していません。
2 つ目の比較では、銀行業務に関する顧客サポートの問い合わせを分類するベンチマーク「Banking77」から 208 件のリクエストをテストしました。この比較では、埋め込みモデルの bge-small とロジスティック回帰を組み合わせた、学習済みの分類器も比較対象に加えられました。学習用の事例を一切与えない条件では、Jev の正解率は 83% でした。一方、教師あり学習を行った分類器の正解率は 93% に達しました。学習済みの分類器は、数千件の事例を通じて、データセット固有の特徴やラベル付けのルールを学習していました。一方、Jev は事前学習だけでは、同等の性能を発揮できませんでした。したがって、学習データと評価データを持つ機械学習チームであれば、重要な業務上の意思決定をゼロショットモデルに任せる前に、まず教師あり学習による分類器を検討すべきです。一方、分類したい内容が頻繁に変わる場合や、ラベル付きデータがない場合には、選択肢が限られてきます。Jev も最先端モデルも、多くのゼロショットタスクでかなり高い正解率を示しますが、正解率だけがすべてではありません。
処理速度とコストも重要です。Banking77 では、同じ評価において、Jev の応答時間の中央値は 0.44 秒でした。テスト対象となった API の設定では、1.51 秒だった GPT-5.6 Terra よりも 3 倍以上高速でした。また、別のフィッシングベンチマークでは、公開価格で比較した場合、Jev のメール 1 通あたりのコストは Claude Haiku 4.5 の約 12 分の 1 でした。リクエストあたりのコストが低く、応答も速ければ、これまでより多くの用途で AI を手頃に利用できるようになります。TypeSafe が期待を寄せているのは、まさにこうした需要です。ただし、モデルの回答数が増えると、それらの回答をどのように組み合わせるかによっては、誤りが積み重なっていく可能性もあります。ローカル環境で動作する教師あり学習の分類器でも、コストを抑えながら、より高速かつ高精度に処理できる場合があります。ただし、こうした分類器は 1 つの質問にしか答えられず、構築と保守にはラベル付きデータと専門知識が必要です。
実際の結果に基づいて学習させる確信度
天気予報アプリが「降水確率 30%」と表示していて、実際に雨が降ったとしても、その予報が間違っていたことにはなりません。その予報は、同じように 30% の降水確率が示された日が 10 日あれば、そのうちおよそ 3 日は雨が降ることを意味しているからです。この性質は「較正 (キャリブレーション)」と呼ばれます。気象予報では何十年も前から、予測確率と実際に観測された結果を比較し、両者にずれが生じた場合にはモデルを修正することで、較正の度合いを測定してきました。Hamill 氏らは、こうした補正によって、米国の National Blend of Models (複数の予測モデルを統合した気象予測システム) における降水予測の信頼性が大幅に向上することを示しました。同システムでは、この手法が 2017 年にこの運用が実用化されました。一方、LLM では、実際に観測された結果と照らし合わせて、同じような方法で評価されることはほとんどありません。
Jev は、3 つの固定形式で回答します。Choice (選択) は、冒頭の例で示したトリアージの判断のように、リストから 1 つの選択肢を選びます。Score (スコア) は、あらかじめ定義された段階的な尺度に沿って評価します。例えば、インシデントの深刻度を「情報提供レベル」から「緊急」までの段階で評価する場合などです。Noul (ベルヌーイの略称) は、ある事柄が真である確率を示します。例えば、あるアラートが悪意のあるものかどうかを判定します。Choice と Score の回答では、Jev は、許可された選択肢または評価レベルごとの確率に加えて、それらの確率がどの程度特定の選択肢やレベルに集中しているかを要約した、別個の確信度指標を返します。Noul では、単一の確率が同じ役割を果たします。確信度指標の尺度では、1.0 が最大値です。ただし、これはモデルがどれほど確信しているかを示すにすぎません。その確信度が、実際の正しさとどの程度結び付いているかは、測定する必要があります。前述の評価では、CLINC150 の 200 件のテスト項目のうち 102 件で、Jevの確信度はちょうど 1.0 でした。しかし、そのうち 6 件は誤った回答でした。
TypeSafe は、Jev の確率をどのように学習させているのか、その詳細を公開していません。同社はこの手法を、較正された意思決定のための強化学習 (RLCD) と呼んでいます。Almeida 氏はインタビューで、RLCD について、新しい学習目標であると説明しましたが、具体的なアルゴリズムについては明らかにしていません。学術研究では、これと類似した目標を実現する方法が示されています。
Jev の公開から 14 か月前の 2025 年 7 月、MIT の Damani 氏らは、それ以前の SaySelf などの研究を発展させ、較正報酬を用いた強化学習 (RLCR) を発表しました。RLCR では、正解と確信度に基づく報酬を用います。各回答には、正解であることに対する報酬から、確信度と実際の結果とのずれに応じたペナルティを差し引いた値が与えられます。このペナルティは、確信度と実際の結果とのずれの二乗に比例して大きくなります。そのため、慎重な誤答よりも、過度に自信を持った誤答のほうが、はるかに大きなペナルティを受けます。この正解・確信度報酬の値は −1 から 1 の範囲で、値が大きいほど望ましいことを示します。実験では、これとは別に、出力形式が適切であることに対する報酬も使用されました。この報酬は表 1 には示されていません。
較正報酬を導入すると、回答に付随する確信度も評価の対象となります。2 つの回答がどちらも誤っていたとしても、一方が他方よりもはるかに強い確信を示していれば、それぞれに異なる報酬が与えられる可能性があります。こうすることで、正しい回答には引き続き報酬を与えながら、過度な確信を伴う誤答を抑制するように学習させることができます。
もう 1 つの比較対象として、検証可能な報酬を用いた強化学習 (RLVR) があります。RLVR では、既知の正解に照らして回答を評価し、通常は正解に 1 点、誤答に 0 点を与えます。この報酬方式は正解率の向上を促しますが、回答で示された確信度は評価対象になりません。
冒頭で取り上げた PowerShell のアラートを例に、あるアクティビティを悪意のあるものか、問題のないものかに分類するモデルを考えてみましょう。過去の調査によって、学習用データに正解ラベルが付けられているとします。表 1 では、回答例、確信度の推定値、およびそれぞれの報酬方式による評価を示しています。RLVR のように正解かどうかだけを評価する報酬方式では、2 つの誤答は同じように扱われ、2 つの正答にも同じ報酬が与えられます。一方、RLCR では、確信度を抑えた誤答のほうが、強い確信を伴う誤答よりも高い報酬を得ます。また、正解した場合も、強い確信を持って正解した回答のほうが、確信が弱いまま正解した回答よりも高い報酬を得ます。
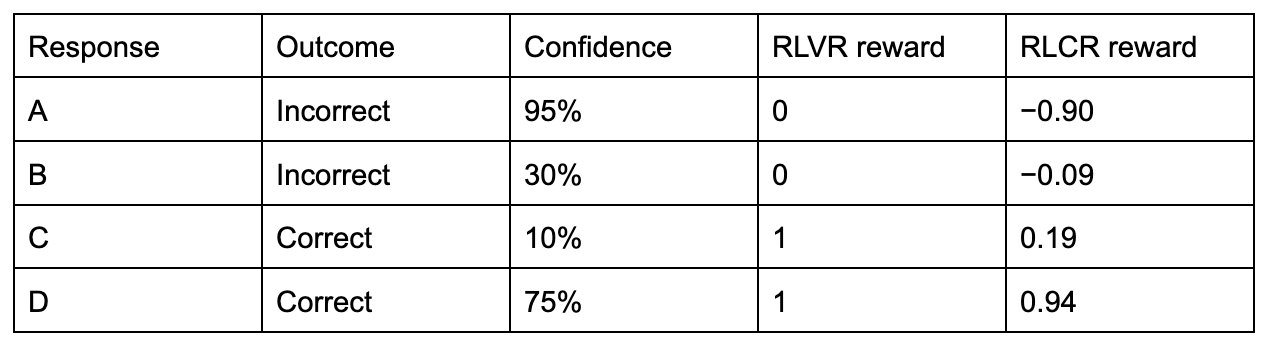
評価器は、検証済みの正解に照らして、各回答とその確信度を採点します。モデルの学習では、こうして得られた報酬を使って、モデルのパラメータを更新します。多数の学習事例を通じて、このような報酬の違いを利用することで、モデルは、どのような証拠が強い確信を裏付け、どのような場合には疑いの余地が残るのかを学習できるようになります。
この例で確信度に対するペナルティの算出に使われているのは、1950 年に天気予報のために考案されたブライアスコアです。ブライアは、予報担当者が、自分の信じている予測とは異なっていても、最も高いスコアを得られる予測を報告することで、評価の仕組みを悪用することを懸念しました。そこで、予測確率と実際に観測された結果とのずれを二乗してペナルティを課すことで、現実に即した確率予測を促す採点方式を考案しました。
Damani 氏らは、複数の Wikipedia ページから情報を組み合わせる必要があるベンチマーク HotpotQA を用いて RLCR を学習させました。その際、学習用の事例から、回答の根拠となる段落の一部を取り除きました。そして、正解かどうかだけを評価する強化学習と比較しました。根拠となる段落がすべて揃っている HotpotQA の質問を使ってテストしたところ、期待較正誤差は、正誤のみを評価する学習では 37% だったのに対し、RLCR では 3% に低下しました。一方、回答の正解率は約 62~63% でほぼ変わりませんでした。つまり、モデルが正解する割合はほぼ同じまま、確信度が回答の信頼性をはるかによく反映するようになったのです。
この改善効果は、事実想起、数学、常識、科学関連の質問など、ほかの分野には部分的にしか引き継がれませんでした。これらのデータセット全体で見ると、較正誤差の平均値は 21% に上昇しました。それでも、平均的には比較対象となったベースラインモデルよりも低い値を維持していました。
Jev に対する独立評価でも、同様の傾向が見られます。分布外データに対する較正の監査では、Jev が学習時に見ていた可能性のある 3 つの公開ベンチマークについて、Jev が出力する確率を補正する必要性はほとんどないことが示されました。別のテストでは、Jev が学習に使用できなかったはずの、合成データによるカスタマーサポートの問い合わせチケットが使われました。Jev には、各チケットを担当すべき部門、対応の緊急度、顧客が怒っているように見えるかどうかを判定させました。緊急度に関する 300 件の質問では、正解を判断するために、Jev に与えられていない組織内のルールを知っている必要がありました。Jev の正解率はわずか 45% でしたが、選択した回答に割り当てた確率の平均値は 74% に達していました。
確信度は、タスクによっても異なっていました。Jev は、問い合わせの担当部門への振り分けや緊急度の判断では、概して実際以上に確信度を高く見積もっていました。一方、怒っている顧客を特定するタスクでは、確信度を実際よりも低く見積もっていました。事前学習済みのシステムであればどのようなものでも、重大な影響を及ぼす可能性のあるタスクに使用する際には、その確率の妥当性を検証する必要があります。
意思決定のしきい値としての確信度
確信度が適切に較正されていれば、コストの異なるアクションの選択と結び付けることで、実運用上の価値が生まれます。エージェント型 SOC では、自動調査を安全に完了してよいのか、それとも人間の担当者に引き継ぐべきなのかを判断する必要があります。実際に侵入が発生している事案をクローズしてしまえば、攻撃を見逃すリスクがあります。一方、すべてのアラートをエスカレーションすると、アラート疲れを引き起こし、アナリストの注意や時間を無駄にしてしまいます。この判断を適切に行うには、3 つの異なる能力が必要です。
較正:その数値は、示されたとおりの意味を持つか?例として、エージェントがアラートを調査し、「これは問題のないアラートです。確信度は 99.9% です」と結論付けたとします。この確信度が適切に較正されているなら、同じ確信度が付けられた同様の事例を多数集めたとき、「問題なし」という判断が正しい割合は約 99.9% になるはずです。この正解率は、同様のアラートに伴うリスクを見積もるための目安になります。ただし、個々の事例の結果を保証するものではありません。残るリスクを許容して自動的にクローズしてよいかどうかは、それとは別に判断する必要があります。
識別能力:確信度の高い判断と低い判断を区別できるか?100 件の判断のうち 90 件が正解で、毎回 90% の確信度を示すモデルを考えてみましょう。全体としては確信度が適切に較正されていますが、確信度からは、追加の確認が必要な 10 件の誤答を見分けることができません。自動化する対象を選別するには、最終的に正解だった判断には高い確信度が、誤りだった判断には低い確信度が付く傾向があることが望まれます。両者を完全に区別できるわけではありませんが、実用上役立つ程度には区別できる必要があります。
意思決定ポリシー:その情報をシステムがどのように活用すべきか?確信度が適切に較正され、正しい判断と誤った判断を有用なレベルで識別できるモデルであっても、組織がどの程度のリスクを許容するかまでは決められません。侵入を示す強い証拠があれば、アナリストへのエスカレーションや、自動対応が適切な場合があります。問題のないアクティビティであることを示す強い証拠があれば、調査を自動的にクローズできる場合があります。証拠が不十分な場合には、追加調査や人間による確認が必要になることがあります。クローズのしきい値は、侵入を見逃した場合の影響、確認作業にかかるコスト、影響を受けるシステムの重要性、そして、ほかのセキュリティ対策によって攻撃を検知できるかどうかによって決まります。ポリシーによっては、エージェントがクローズを推奨し、アナリストが確認することは認める一方、調査を自動的にクローズするには、より強い証拠を求めることもできます。Sophos MDR では、AI エージェントは、アナリストが設定した境界の範囲内でのみ、ケースの処理を最初から最後まで自動的に完了します。また、リスクの高いアクションを実行する前には、影響の大きい判断を人間が介在するプロセスに回します。
CLINC150 の評価では、まさにこのような振り分け方針が検証されました。まず、各リクエストを Jev または gpt-5.4-nano という、より低コストのモデルに処理させました。そして、確信度が設定したしきい値を下回る回答は、より高コストの GPT-5.6 Terra に引き継ぎました。ここで検証されたのは、最終的にどれだけの割合のリクエストを Terra に処理させる必要があるか、という点です。Terra の正解率との差を 1 パーセントポイント以内に抑えることを目標とした場合、Jev を最初に使う方式ではリクエストの 22% が、nano を最初に使う方式では 49% が、Terra に引き継がれました。ところが、Terra と完全に同じ正解率を目指すと、結果は逆転しました。Jev を最初に使う方式では、すべてのリクエストを Terra に送る必要がありました。一方、nano を最初に使う方式では、73% を Terra に引き継ぐだけで済みました。
この逆転は、Jev が最大の確信度を示した回答によって生じました。Jev は 200 件の回答のうち 102 件に、最大値である確信度 1.0 を付けていました。しかし、そのうち 6 件は誤答でした。しきい値による振り分けでは、スコアの異なる回答を区別することしかできません。そのため、この 6 件の誤答のうち、Terra なら正解できた誤答を 1 件でも拾い上げようとすると、確信度 1.0 を付けられた 102 件すべてを Terra に引き継がなければなりませんでした。そうなると、最初に低コストのモデルを使う意味はなくなってしまいます。評価結果には、安定性にも課題がありました。データの半分を使って設定したしきい値では、残り半分のデータに対して、正解率の差を 1 パーセントポイント以内に抑えるという目標を達成できませんでした。また、2 つのベンチマークのいずれにおいても、Jev と nano のどちらか一方が、自らの誤答を見つけるうえで一貫して優れているとはいえませんでした。有望な結果が 1 つ得られただけでは、本番環境で使用するしきい値を決める根拠としては不十分です。しきい値は、実際に運用する環境から取り出した、モデルの学習や調整には使用していない検証用データを使って設定する必要があります。
より単純な質問と、学習済みの意思決定ルール
公開されているフィッシングベンチマークでも、別の比較結果が示されています。このベンチマークの作成者は、実在するフィッシング URL と正規の URL を基に本文を合成した 2,000 通のメールを用意し、それぞれについて、メールを処理するエージェントがリンクをクリックすべきかどうかを Jev と Claude Haiku 4.5 に直接質問しました。その結果、Jev の正解率は 63% で、フィッシングメールの 43% を検知しました。一方、Haiku の正解率は 81% で、フィッシングメールの 76% を検知しました。
同じ研究の別の実験では、この作成者は Jev を使って、別の分類器に入力する特徴量を生成しました。Jev は、リンク先が URL 短縮サービスや無料のホスティングプラットフォームを指しているかどうかなど、より細分化した 5 つの質問について、確率の推定値を出力しました。別途用意したロジスティック回帰分類器に、これらの特徴量と 1,000 通のメールの正解ラベルを与えて学習させたところ、残りの 1,000 通のメールに対する正解率は 95% に達しました。
この 2 つ目の実験では、データセットの特徴を踏まえて設計した質問と、教師あり学習を組み合わせています。著者は、データセットに含まれる URL の検知回避手法を調べたうえで質問を設計し、別の分類器にはラベル付きの事例から学習させました。また、正解率の評価方法も異なります。2 つ目の実験では、学習に使用していない半分のデータで評価したのに対し、メールごとに直接判定させた実験では、2,000 通すべてを評価対象としました。この実験結果は、意思決定を小さく検証可能な質問に分解するという Almeida 氏の提案を支持するものです。ただし、質問を分解したことだけが性能向上につながったと証明するものではありません。むしろ、この結果からは、モデルの回答を特徴量として、従来のルールや分類器と組み合わせて検証し、実測した性能に基づいて、どの要素を実際の業務フローに組み込むかを判断するというアプローチが考えられます。
自社のアラートを使った検証
天気予報が役立つのは、予報の評価方法が何十年もかけて確立されてきたからです。予測した確率と実際に観測された頻度を比較し、偏りを特定して修正します。どれほど高度なモデルであっても、実際の結果と照らし合わせて評価し続けることが、予報への信頼につながっています。
セキュリティチームの場合、これは Jev を自社のアラートで評価し、ルールベースの手法、学習済みの分類器、生成 AI モデルと比較することを意味します。質問ごとに、別途用意した較正用データセットを使って確信度のしきい値を設定します。そのうえで、学習やしきい値の調整に使用していないテストデータセットを使い、侵入の見逃し、アナリストの作業負荷、総コストを測定します。このコストには、再試行、追加のモデル呼び出し、人間によるレビューも含めます。選択的予測などの統計的手法を使えば、較正用データセットに基づいて、自動処理する判断における誤り率の上限を推定できます。さらに、顧客、期間、新たな攻撃手法を変えながら、こうした検証を繰り返します。回答の選択肢の順番を入れ替えたり、関係のない選択肢を追加したりしたときに、確率がアクションを変えるほど大きく変動しないかどうかもテストします。言語モデルは、選択肢の表示位置やラベルによって回答が偏ることが知られています。Jevの出力でも、この両方の影響が見られたという報告があります。また、アラートの各フィールドに敵対的なテキストを含めたテストも実施します。モデルが読み取る証拠の一部は、攻撃者が書き込める場合があるためです。こうした測定の結果、ワークフローの改善につながることが確認できた場面で、Jev を活用することになります。判断 1 回あたりのコストが下がるほど、チームはワークフローのより多くの部分を自動化できるようになります。ただし、忘れてはならないのは、判断のコストが安くても、誤りによる損失が自動化による節約額を上回るなら、結局は割に合わないということです。
調査およびブログ記事の作成には、AI アシスタントの Hermes が使用されました。この記事の締めくくりの一言がウケる確率は 30% と予測し、より多くの人を対象に評価してほしいと求めています。