


Imagina una alerta de ciberseguridad sobre un script de PowerShell potencialmente malicioso que descarga y ejecuta un archivo. Un agente de IA en un centro de operaciones de seguridad (SOC) puede gestionarla eligiendo entre un conjunto fijo de acciones: cerrar la alerta como inofensiva, recopilar más pruebas o enviarla a un analista. Antes de dejar que el agente actúe ante este tipo de alertas, el SOC necesita saber con qué frecuencia acierta y si su nivel de confianza ayuda a identificar sus errores.
TypeSafe.ai creó Jev para este tipo de tareas de toma de decisiones. Un desarrollador proporciona un contexto estructurado, una pregunta y las respuestas permitidas, y Jev devuelve probabilidades para esas respuestas sin generar una respuesta de texto extensa. TypeSafe presenta este diseño como mucho más rápido y económico por decisión que un modelo de lenguaje grande (LLM) de uso general. En una entrevista en Latent Space, el cofundador y director ejecutivo de TypeSafe, Diogo Almeida, describió una clase de modelos en los que «el objetivo es que el código sea el consumidor». Quiere que estas valoraciones sean lo suficientemente fiables como para que los desarrolladores puedan recurrir a ellas con la misma naturalidad que a una consulta de base de datos. TypeSafe bautizó a Jev en honor a la paradoja de Jevons, según la cual una mayor eficiencia genera suficiente demanda adicional como para aumentar el consumo total de recursos. Esto apunta a la paradoja de Jev. Si Jev toma decisiones automatizadas lo suficientemente baratas como para ejecutarlas en cualquier sistema, los equipos automatizarán muchas más decisiones, y cualquier tasa de error por encima del nivel de referencia actual, ya sea humana o automatizada, se traducirá en un mayor número total de errores.
El hecho de que siempre devuelva una respuesta válida hace que Jev sea fácil de integrar. La frecuencia con la que elija la respuesta correcta determina si resulta útil. Si además sabe cuándo una respuesta propuesta no es fiable, eso puede influir en la cantidad de trabajo que se puede automatizar de forma segura. Son tres propiedades distintas, y el revuelo en torno al lanzamiento de Jev las ha difuminado un poco.
Los clasificadores que aceptan sus etiquetas en tiempo de ejecución no son nada nuevo. Al menos desde 2019, los modelos de inferencia de lenguaje natural han gestionado la clasificación «zero-shot» comprobando si una entrada respalda una afirmación como «esta alerta es maliciosa» sin necesidad de volver a entrenar el modelo. Una prueba comparativa de marzo de 2026 comparó estos modelos con modelos de incrustación, reordenadores y LLM ajustados por instrucciones. TypeSafe no ha publicado la arquitectura de Jev, así que no está claro dónde encaja Jev entre ellos, aunque su objetivo de entrenamiento declarado —tomar decisiones calibradas— se asemeja a investigaciones publicadas que comentaremos más adelante. En cualquier caso, la novedad debería importarle menos a un SOC que si Jev mejora su flujo de trabajo, y merece la pena echar un vistazo más de cerca a las primeras pruebas independientes que publicaron tras el lanzamiento.
Las ventajas de Jev dependen de lo que sustituya
Una evaluación independiente comparó a Jev con los modelos de OpenAI en dos pruebas de clasificación de intenciones. La evaluación analizó 200 solicitudes de CLINC150, una prueba para identificar qué le está pidiendo un usuario a un chatbot. Jev alcanzó una precisión del 87 % sin ejemplos de entrenamiento, frente al 80 % del pequeño modelo gpt-5.4-nano y al 92 % de GPT-5.6 Terra. Terra se sitúa por debajo de GPT-5.6 Sol y GPT-6 Astra en la gama de OpenAI, así que Jev es un clasificador «zero-shot» decente, pero no alcanza la calidad de los modelos de vanguardia.
La segunda comparación analizó 208 solicitudes de Banking77, un banco de pruebas para clasificar las solicitudes de atención al cliente en el sector bancario, y añadió a la mezcla un clasificador entrenado que utilizaba el modelo de incrustación bge-small con regresión logística. Sin ningún ejemplo de entrenamiento, Jev alcanzó un 83 %, mientras que el codificador supervisado llegó al 93 %. El clasificador entrenado aprendió las peculiaridades del conjunto de datos y las convenciones de etiquetado a partir de miles de ejemplos, mientras que Jev no rindió tan bien solo con su preentrenamiento. Así que un equipo de aprendizaje automático con datos de entrenamiento y evaluación debería seguir empezando con un clasificador supervisado antes de confiar en modelos «zero-shot» para decisiones empresariales importantes. Por otro lado, si tus preguntas cambian a menudo o no tienes datos etiquetados, tus opciones son más limitadas. Tanto Jev como los modelos Frontier son bastante precisos en muchas tareas «zero-shot», pero la precisión no lo es todo.
La velocidad y el coste también importan. En Banking77, la misma evaluación registró tiempos de respuesta medios de 0,44 segundos para Jev, más de tres veces más rápido que GPT-5.6 Terra, que tardó 1,51 segundos en las configuraciones de API probadas. Una prueba de referencia sobre phishing independiente reveló que Jev es unas 12 veces más barato por correo electrónico que Claude Haiku 4.5 a precios de catálogo. Unos costes más bajos por solicitud y unas respuestas más rápidas pueden hacer que varios casos de uso resulten más asequibles. Esa es la demanda por la que apuesta TypeSafe, aunque un mayor número de respuestas del modelo puede agravar los errores dependiendo de cómo se combinen las respuestas. Un clasificador supervisado que se ejecute localmente también puede ser más barato, más rápido y más preciso. El inconveniente es que solo responde a una pregunta y necesita datos etiquetados y conocimientos especializados para su creación y mantenimiento.
Confianza entrenada en función de los resultados
Cuando una app meteorológica dice que hay un 30 % de probabilidad de lluvia, la previsión no es errónea si llueve. Se supone que lloverá aproximadamente tres de cada diez días en los que se emita ese pronóstico. A esa propiedad se le llama calibración, y los meteorólogos la llevan midiendo desde hace décadas comparando las probabilidades indicadas con los resultados observados y corrigiendo sus modelos cuando ambos se desvían. Hamill et al. demostraron cómo esas correcciones mejoraron sustancialmente la fiabilidad de las previsiones de precipitaciones para la National Blend of Models de EE. UU., que adoptó el método de forma operativa en 2017. Rara vez alguien compara los modelos de lenguaje grande (LLM) con los resultados observados de la misma manera.
Jev responde utilizando tres formatos preestablecidos. La opción «Choice» (Elección) selecciona una alternativa de una lista, como la decisión de triaje mencionada al principio. La opción «Score» (Puntuación) sitúa un elemento en una escala de niveles definida por el usuario, como la gravedad de un incidente (desde informativo hasta crítico). La opción «Noul» (abreviatura de Bernoulli) indica la probabilidad de que algo sea cierto, por ejemplo, si una alerta es maliciosa. Para las respuestas de tipo «Choice» y «Score», Jev devuelve probabilidades asociadas a las opciones o niveles permitidos, junto con una estadística de confianza independiente que resume el grado de concentración de dichas probabilidades; en el caso de «Noul», la probabilidad única desempeña la misma función. Un valor de 1,0 representa el límite superior de la escala de confianza, pero refleja únicamente la certeza del modelo; su relación con la exactitud debe medirse por separado. En la evaluación descrita anteriormente, la confianza de Jev fue exactamente de 1,0 en 102 de los 200 ítems de CLINC150, y seis de esas respuestas eran incorrectas.
TypeSafe no ha publicado cómo entrena las probabilidades de Jev. Denomina a su enfoque «aprendizaje por refuerzo para decisiones calibradas» (RLCD), y Almeida describió el RLCD en la entrevista como un nuevo objetivo de entrenamiento, sin especificar ningún algoritmo. La investigación académica muestra una forma de perseguir un objetivo similar.
Catorce meses antes del lanzamiento de Jev, en julio de 2025, Damani et al. del MIT presentaron el aprendizaje por refuerzo con recompensas de calibración (RLCR), basándose en trabajos anteriores como SaySelf. Bajo la recompensa de corrección y confianza del RLCR, cada respuesta obtiene una recompensa por corrección menos una penalización por la diferencia entre su confianza y el resultado. La penalización aumenta con el cuadrado de esa diferencia, por lo que los errores por exceso de confianza salen mucho más caros que los cometidos con cautela. Esta recompensa por corrección y confianza oscila entre −1 y 1, siendo mejores los valores más altos. Los experimentos también utilizaron una recompensa separada por el formato de la salida que no aparece en la Tabla 1.
Las recompensas de calibración aportan información sobre el nivel de confianza asociado a una respuesta. Dos respuestas incorrectas pueden recibir recompensas diferentes si una expresa mucha más confianza que la otra. Así, el entrenamiento puede disuadir de cometer errores por exceso de confianza sin dejar de recompensar las respuestas correctas.
Como otro punto de comparación, el aprendizaje por refuerzo con recompensas verificables (RLVR) puntúa una respuesta frente a un resultado conocido, normalmente dando un punto por una respuesta correcta y cero por una incorrecta. Esa recompensa fomenta la precisión, mientras que no puntúa la confianza indicada.
Piensa en la alerta de PowerShell del principio e imagina un modelo que clasifique la actividad como maliciosa o benigna. Supongamos que investigaciones previas han verificado las etiquetas para el entrenamiento. La tabla 1 muestra respuestas ilustrativas, estimaciones de confianza y diferentes señales de recompensa. Las recompensas basadas solo en la corrección, como el RLVR, tratan los errores por igual y las respuestas correctas por igual, mientras que el RLCR otorga al error cauteloso una recompensa mayor que al error con confianza. También otorga a la respuesta correcta con confianza una recompensa mayor que a la respuesta correcta vacilante.
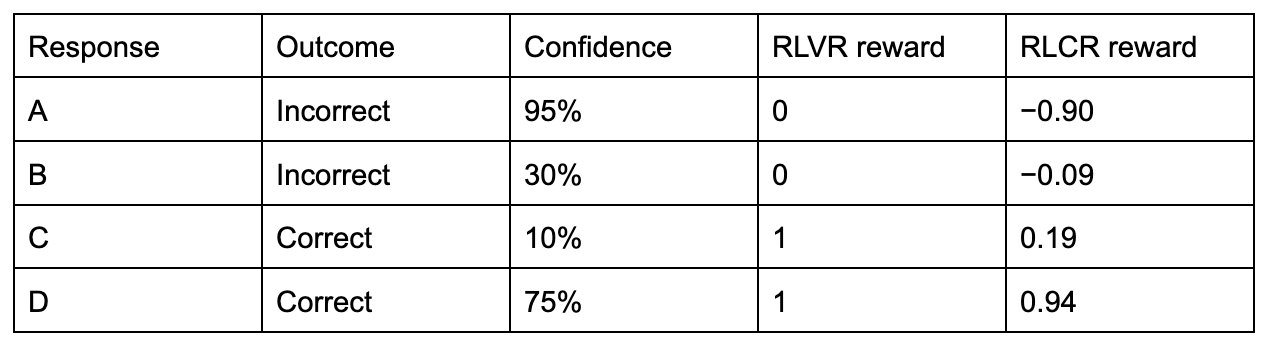
El evaluador puntúa cada respuesta y su nivel de confianza comparándolas con el resultado verificado. El entrenamiento utiliza estas recompensas para actualizar los parámetros del modelo. A lo largo de muchos ejemplos de entrenamiento, esas diferencias pueden ayudar al modelo a aprender qué pruebas respaldan una mayor confianza y cuáles dejan margen para la duda.
La penalización por confianza del ejemplo proviene de la puntuación de Brier, introducida para la predicción meteorológica en 1950. A Brier le preocupaba que los meteorólogos se aprovecharan del sistema, informando de lo que les diera la mejor puntuación aunque difiriera de lo que ellos creían. Su regla de puntuación fomentaba estimaciones de probabilidad realistas al penalizar la diferencia al cuadrado entre las probabilidades predichas y los resultados observados.
Damani et al. entrenaron el RLCR en HotpotQA, un banco de pruebas que requiere combinar información de varias páginas de Wikipedia, con algunos párrafos de apoyo eliminados de los ejemplos de entrenamiento. Lo compararon con el aprendizaje por refuerzo basado solo en la corrección. Al probarlo con preguntas de HotpotQA en las que sí aparecían los párrafos de apoyo, el error de calibración esperado bajó del 37 % con el entrenamiento basado solo en la corrección al 3 % con el RLCR, mientras que la precisión de las respuestas se mantuvo en torno al 62-63 %. La confianza se volvió mucho más informativa, mientras que los modelos respondían correctamente más o menos la misma proporción de preguntas.
La mejora solo se trasladó en parte a otros ámbitos, como la recuperación de datos fácticos, las matemáticas, el sentido común y las preguntas relacionadas con la ciencia. En esos conjuntos de datos, su error de calibración medio subió al 21 %, aunque seguía siendo, de media, inferior a los valores de referencia.
Las pruebas independientes de Jev muestran un patrón similar. Una auditoría de calibración fuera de la distribución reveló que las probabilidades de Jev apenas necesitaban correcciones en tres bancos de pruebas públicos que podría haber visto durante el entrenamiento. Otra prueba utilizó tickets sintéticos de atención al cliente con los que no podría haberse entrenado. Los evaluadores preguntaron a Jev qué departamento debía gestionar cada ticket, qué grado de urgencia tenía y si el cliente parecía enfadado. En 300 preguntas sobre urgencia, la respuesta correcta dependía de una norma de la empresa que no se había facilitado a Jev. Solo respondió correctamente al 45 %, pero asignó a sus respuestas elegidas una probabilidad media del 74 %.
La confianza también variaba según la tarea. En general, Jev exageraba su certeza sobre el desvío de casos y la urgencia, pero la subestimaba a la hora de identificar a clientes enfadados. Como cualquier sistema preentrenado, las probabilidades deben validarse para cualquier tarea con implicaciones graves.
La confianza como umbral de decisión
La confianza calibrada cobra interés operativo cuando se relaciona con acciones que conllevan diferentes costes. Un SOC autónomo tiene que decidir si puede cerrar con seguridad una investigación automatizada o si debe pasársela a una persona. Cerrar un caso de intrusión real conlleva el riesgo de pasar por alto un ataque. Escalarlo todo provoca fatiga por alertas y desperdicia la atención de los analistas. Tomar esa decisión requiere tres capacidades distintas.
Calibración: ¿el número significa realmente lo que indica? A modo de ejemplo, imagina que un agente investiga una alerta y concluye: «Esto es inofensivo. Tengo un 99,9 % de confianza». Si esa confianza está calibrada, la conclusión de que es inofensivo debería ser correcta aproximadamente el 99,9 % de las veces en casos comparables que reciban esa puntuación. Esa frecuencia ofrece una estimación del riesgo para una alerta similar, aunque no puede garantizar el resultado de ningún caso concreto. Si el riesgo restante es aceptable para el cierre automático es otra decisión aparte.
Discriminación: ¿puede distinguir sus conclusiones más sólidas de las más débiles? Imagina un modelo que acierta 90 de cada 100 decisiones y siempre indica un 90 % de confianza. En general está bien calibrado, pero su nivel de confianza no ayuda a identificar los 10 errores que podrían beneficiarse de una revisión más detallada. Para facilitar la automatización selectiva, la confianza debería tender a ser mayor para las conclusiones que resultan correctas y menor para las que resultan erróneas. La distinción no será perfecta, pero debería ser útil.
Política de decisión: ¿qué debería hacer el sistema con esa información? Ni siquiera un modelo bien calibrado con una capacidad de discriminación útil determina qué nivel de riesgo está dispuesta a aceptar una organización. Una evidencia sólida de intrusión puede justificar que se eleve el caso o se active una respuesta automática. Una evidencia sólida de actividad inofensiva puede hacer que una investigación sea apta para su cierre automático. Una evidencia insuficiente puede requerir una investigación más profunda o una revisión humana. El umbral de cierre depende de las consecuencias de pasar por alto una intrusión, el coste de la revisión, lo crítico que sea el sistema afectado y si otros controles seguirían detectando un ataque. La política puede permitir que el agente recomiende el cierre para que un analista lo revise, al tiempo que exige una evidencia más sólida antes de que pueda cerrar una investigación automáticamente. En Sophos MDR, los agentes de IA cierran los casos de principio a fin solo dentro de los límites que establecen los analistas, y los analistas reciben las decisiones de mayor riesgo antes de que el sistema tome una medida arriesgada.
La evaluación CLINC150 puso a prueba precisamente este tipo de política. El sistema enviaba cada solicitud primero a un modelo más económico, ya fuera Jev o gpt-5.4-nano, y derivaba cualquier respuesta por debajo de un umbral de confianza al modelo más caro, el GPT-5.6 Terra. La pregunta era cuánto tráfico tenía que llegar aún a Terra. Cuando el objetivo era acercarse a un punto porcentual de la precisión de Terra, el enrutamiento «Jev primero» derivaba el 22 % de las solicitudes y el enrutamiento «nano primero» derivaba el 49 %. Cuando el objetivo era igualar exactamente a Terra, el resultado se invertía. El enrutamiento «Jev primero» tenía que enviar todas las solicitudes a Terra, mientras que el enrutamiento «nano primero» enviaba el 73 %.
El cambio se debió a las respuestas de máxima confianza de Jev. Jev otorgó a 102 de las 200 respuestas una confianza de exactamente 1,0, y seis de ellas eran incorrectas. Un umbral de corte solo puede separar respuestas con puntuaciones diferentes, así que para recuperar uno de esos seis errores que Terra había acertado había que escalar las 102, y para entonces la primera etapa, más barata, ya no estaba haciendo ningún trabajo útil. Los resultados también fueron frágiles. Los umbrales elegidos con la mitad de los datos no alcanzaron el objetivo de un punto en la otra mitad, y la confianza de ninguno de los modelos demostró ser sistemáticamente mejor a la hora de detectar sus propios errores en las dos pruebas de referencia. Un resultado prometedor es una base demasiado débil para un umbral de producción. Hay que elegir el umbral a partir de casos no utilizados del entorno en el que se va a ejecutar.
Preguntas más concretas y reglas de decisión entrenadas
Un banco de pruebas público sobre phishing ofrece otra comparación. Su autor preguntó a Jev y a Claude Haiku 4.5 si un usuario de correo electrónico debía hacer clic en el enlace de cada uno de los 2000 correos, cuyos cuerpos sintéticos se basaban en URL reales de phishing y legítimas. Al preguntárselo directamente, Jev alcanzó una precisión del 63 % y detectó el 43 % de los correos de phishing, mientras que Haiku alcanzó el 81 % y detectó el 76 %.
En un experimento aparte dentro del mismo estudio, el autor usó Jev para generar características para otro clasificador. Jev proporcionó estimaciones de probabilidad para cinco preguntas más específicas, como si un enlace apuntaba a un acortador de URL o a una plataforma de alojamiento gratuita. Un clasificador de regresión logística independiente aprendió a partir de esas características y de las etiquetas de 1000 correos electrónicos, y luego alcanzó una precisión del 95 % en los 1000 restantes.
El segundo experimento combinó preguntas basadas en el conjunto de datos con entrenamiento supervisado: el autor diseñó las preguntas tras estudiar el catálogo de técnicas de evasión de URL del conjunto de datos, y el clasificador independiente aprendió a partir de ejemplos etiquetados. El autor midió su precisión en la mitad de los datos reservados, mientras que evaluó los veredictos directos en los 2000 correos electrónicos. El experimento respalda el consejo de Almeida de dividir las decisiones en preguntas pequeñas y comprobables, aunque no demuestra que la descomposición por sí sola generara la mejora. Sugiere probar las respuestas del modelo como características junto a las reglas y clasificadores convencionales, y luego dejar que el rendimiento medido decida qué componentes deben formar parte del flujo de trabajo.
Validación con tus propias alertas
Las previsiones meteorológicas son útiles porque los meteorólogos han dedicado décadas a desarrollar una disciplina de evaluación. Trazan las probabilidades previstas frente a las frecuencias observadas, identifican sesgos y realizan ajustes. Su fiabilidad proviene de comparar cada modelo con la realidad, por muy sofisticado que sea, y siguen midiendo.
Para un equipo de seguridad, eso significa evaluar Jev con tus propias alertas comparándolo con reglas, clasificadores entrenados y modelos generativos. Elige umbrales de confianza en un conjunto de calibración independiente para cada pregunta y, a continuación, mide las intrusiones no detectadas, la carga de trabajo de los analistas y el coste total en un conjunto de prueba sin modificar, incluyendo reintentos, solicitudes adicionales al modelo y revisión humana. Métodos estadísticos como la predicción selectiva pueden convertir ese conjunto de calibración en un límite para la tasa de error entre las decisiones automatizadas. Repite las comprobaciones con distintos clientes, periodos de tiempo y nuevas técnicas de ataque. Comprueba si cambiar el orden de las opciones de respuesta o añadir una opción irrelevante modifica las probabilidades lo suficiente como para alterar una acción. Se sabe que los modelos de lenguaje favorecen ciertas posiciones y etiquetas de respuesta, y algunos han observado ambos tipos de sensibilidad en los resultados de Jev. Incluye texto adversarial en los campos de las alertas, porque los atacantes a menudo pueden escribir parte de la evidencia que lee el modelo. Usa Jev siempre que esas mediciones indiquen que mejora el flujo de trabajo. Cuanto más barato resulte cada juicio, mayor será la parte del flujo de trabajo que un equipo pueda permitirse automatizar. Pero recuerda siempre que las decisiones más baratas solo son una ganga si los errores no cuestan más de lo que se ahorra con la automatización.
Hermes, un asistente de IA, prestó asistencia en la investigación y la redacción del blog. Le da a esta ocurrencia un 30 % de posibilidades de que tenga éxito y pide que se evalúe con una muestra más amplia.